Задание 3. Сравнение структурного и MSA-выравнивания
Выравнивание по совмещению структур
Выбраны белки с доменом глобинов (PDB ID): 1k0k, 1cqa, 2jkf. Выравнивание выполнено по A-цепи.
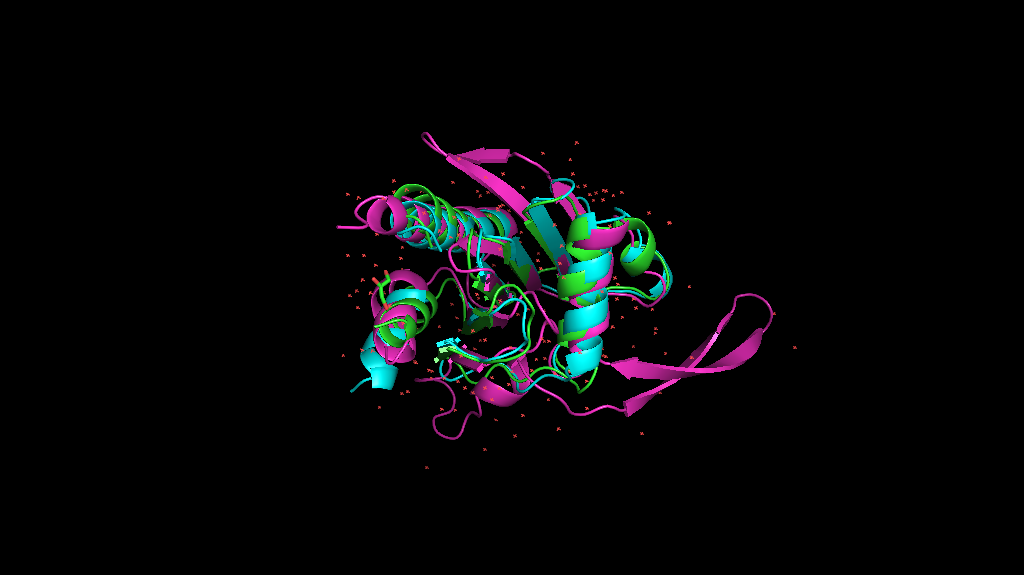
Схема выравнивания последовательностей, полученного из структурного совмещения
На основе структурного совмещения были составлены следующие колонки выравнивания (схематично):
Сравнение структурного выравнивания с выравниванием программой MSA
Сравниваемые выравнивания (формат FASTA):
Проект Jalview со сравниваемыми выравниваниями: [ссылка]
Найденные совпадающие и несовпадающие участки:
Сравнение двух выравниваний:
Общие последовательности (3): 1cqa, 1k0k, 2jkf
| Длина MSA | 173 |
|---|---|
| Длина PDBeFold | 178 |
| Совпадающих колонок | 98 |
| % от MSA | 56.6% |
| % от PDBeFold | 55.1% |
| Всего блоков | 10 |
| Одиночных совпадений вне блоков | 1 |
Блоки (длина >= 2), по убыванию длины:
| (s1,f1) | (s2,f2) | длина |
|---|---|---|
| (56,84) | (60,88) | 29 |
| (89,105) | (93,109) | 17 |
| (152,167) | (157,172) | 16 |
| (122,133) | (127,138) | 12 |
| (137,146) | (142,151) | 10 |
| (31,33) | (35,36) | 3 |
| (44,46) | (47,49) | 3 |
| (114,116) | (119,121) | 3 |
| (7,8) | (9,10) | 2 |
| (48,49) | (51,52) | 2 |
Одиночные совпадения вне блоков:
| (1,1) |
Несовпадающие участки в MSA:
| Участок | Длина |
|---|---|
| 1–6 | 6 |
| 9-30 | 22 |
| 34-43 | 10 |
| 47–47 | 1 |
| 50-55 | 6 |
| 85-88 | 4 |
| 106-113 | 8 |
| 117-121 | 5 |
| 134-136 | 3 |
| 147-151 | 5 |
| 168-173 | 6 |
Обсуждение результата
Структурное выравнивание, полученное по совмещению трехмерных структур, показывает высокую степень сходства с выравниванием, сделанным программой MSA. Обнаружено несколько протяженных консервативных блоков, соответствующих элементам вторичной структуры. Основные различия наблюдаются в петлевых участках, где структурное выравнивание может вводить больше делеций для оптимального пространственного совмещения, в то время как алгоритм MSA ориентируется исключительно на аминокислотную последовательность. В целом, структурное выравнивание подтверждает качество выравнивания, полученного программой MSA.
Задание 4. Краткое описание программы MSA: MUSCLE
Общее описание
MUSCLE (Multiple Sequence Comparison by Log-Expectation) — это программа для множественного выравнивания последовательностей, разработанная Робертом Эдгаром и представленная в 2004 году [1]. Она используется для того, чтобы расположить несколько последовательностей (например, белков или нуклеиновых кислот) друг под другом таким образом, чтобы сходные участки оказались в одних и тех же позициях. Основное преимущество MUSCLE заключается в сочетании высокой точности и высокой скорости работы, что делает его удобным инструментом при анализе больших наборов данных [1].
Алгоритм работы
Алгоритм работы MUSCLE включает три основных этапа [1, 2]. На первом этапе программа быстро оценивает степень сходства между последовательностями, строит на основе этих оценок направляющее дерево и выполняет предварительное выравнивание; приоритетом здесь является скорость. На втором этапе оценки сходства уточняются, дерево перестраивается, и участки, где порядок ветвления изменился, выравниваются заново. На третьем этапе программа многократно пытается улучшить отдельные фрагменты выравнивания и сохраняет только те варианты, которые получают более высокую оценку. Работу можно завершить на любом из этапов, выбирая тем самым подходящий баланс между скоростью и точностью [2].
Сравнение с другими программами
В оригинальной работе автор сравнивал MUSCLE с другими распространёнными программами (T-Coffee, MAFFT и CLUSTALW) на стандартных тестовых наборах данных [1]. По результатам сравнения MUSCLE показал наивысшую или одну из наивысших оценок точности. Если же пропустить заключительный этап уточнения, точность оказывается сопоставимой с T-Coffee и MAFFT, однако по скорости MUSCLE превосходит их — например, выравнивание 5000 последовательностей средней длины занимает около семи минут [1].
MUSCLE v5
Следует также упомянуть MUSCLE v5 — существенно переработанную версию с новым алгоритмом [3]. Она точнее предыдущих версий, на многих тестах превосходит MAFFT и Clustal Omega, способна обрабатывать десятки тысяч последовательностей и позволяет строить несколько вариантов выравнивания, что даёт возможность оценить надёжность полученного результата [3].
Источники
- Edgar, R. C. (2004). MUSCLE: multiple sequence alignment with high accuracy and high throughput. Nucleic Acids Research, 32(5), 1792–1797.
- Edgar, R. C. (2004). MUSCLE: a multiple sequence alignment method with reduced time and space complexity. BMC Bioinformatics, 5, 113.
- Debian Packages. muscle (1:5.1.0-1).