Обзор особенностей генома бактерии Salmonella enterica subsp. enterica serovar Typhimurium str. LT2
Факультет биоинженерии и биоинформатики Московского государственного университета имени М.В. Ломоносова
Аннотация
Данный обзор посвящен изучению и анализу геномной последовательности бактерии Salmonella enterica subsp. enterica serovar Typhimurium str. LT2. В ходе исследования были получены результаты по распределению длин белков протеома, частотам встречаемости старт-кодонов в геноме, распределению числа белок-кодирующих генов и генов разных типов РНК, GC%-составу генома, а также была установлена длина нетранслируемых областей в генах.
Введение
Во введении я процитирую статью "McClelland M. et al. Complete genome sequence of Salmonella enterica serovar Typhimurium LT2": "Salmonella enterica subsp. enterica serovar Typhimurium str. LT2 - подвид Salmonella enterica, палочковидной, жгутиковой, аэробной грамотрицательной бактерии.
Род Salmonella включает два вида: S. enterica, который подразделяется на более чем 2000 подвидов, и Salmonella bongori. Некоторые подвиды S. enterica, такие как S. typhi, вызывают системные инфекции и брюшной тиф, в то время как другие, например, S. typhimurium, приводят к гастроэнтериту. Отдельные подвиды, такие как S. typhi, являются узкоспециализированными паразитами, заражающими только людей, тогда как другие, например, S. typhimurium, являются универсальными паразитами, встречающимися как у людей, так и у многих других видов млекопитающих. Домашние животные выступают в качестве переносчика для пищевого распространения универсальных возбудителей инфекций, что обусловливает высокую заболеваемость нетифозными сальмонеллезными инфекциями по всему миру. Оценочный ущерб от болезней пищевого происхождения в США (значительную часть которых составляет сальмонеллез) колеблется от 4,8 до 23 миллиардов долларов.
Штамм Salmonella typhimurium LT2, основной штамм для клеточной и молекулярной биологии сальмонелл, был выделен в 1940-х годах и использовался в первых исследованиях фаг-опосредованной трансдукции. Аттенуированные (сниженные в патогенности) мутанты S. enterica могут использоваться в качестве живых оральных вакцин против сальмонеллезной инфекции, для экспрессии антигенов других патогенов и для доставки белков в солидные опухоли.
Систематика:
- Домен: Бактерии
- Отдел: Протеобактерии
- Класс: Гамма-протеобактерии
- Порядок: Enterobacterales
- Семейство: Энтеробактерии
- Род: Сальмонеллы
- Вид: Salmonella enterica
- Подвид: Salmonella enterica subsp. enterica
Методы
1. Получение данных. Данные о нуклеотидных последовательностях белок-кодирующих генов, нуклеотидном составе всего генома и данные о локальных особенностях генома изучаемой бактерии были получены из банка геномов с сайта NCBI. Названия файлов, использовавшиеся при исследовании генома и протеома, следующие: GCF_000006945.2_ASM694v2_cds_from_genomic.fna, GCF_000006945.2_ASM694v2_feature_table.txt, GCF_000006945.2_ASM694v2_genomic.fna.
2. Для подсчета длин белков, закодированных в геноме бактерии, была импортирована таблица в соответствующий лист книги Google Sheets, и на основе ее данных была построена гистограмма, отображающая среднее значение длин белков, закодированных в геноме. Использовались такие методы электронных таблиц, как COUNTIFS, MAX, MIN. Таблицу с полученными данными можно найти в разделе "Сопроводительные материалы" Таблица S1.
3. Для подсчёта числа генов белков и генов разных типов РНК в каждом репликоне использовался метод электронных таблиц "COUNTIF". Путём анализа таблицы с данными было обнаружено, что необходимо провести отбор значений по ключевым словам в соответствующих столбцах, чтобы подсчитать число генов белков и РНК. Для этого я воспользовался функцией "фильтр", которая позволила мне отобрать только удовлетворяющие условиям задачи значения, после чего построил таблицу, в ячейках которой были подсчитаны количества генов белков и генов различных видов РНК отдельно для хромосомы (содержащей один единственный репликон) и плазмиды. Таблицу с полученными данными можно найти в разделе "Сопроводительные материалы" Таблица S2.
4. Анализ GC%-состава генома проводился с помощью методов электронных таблиц, а в частности, MIN, MAX, COUNTIFS. На основе построенной таблицы была построена гистограмма. Таблицу с полученными данными можно найти в разделе "Сопроводительные материалы" Таблица S3.
5. Количественный подсчет нуклеотидов в геноме проводился с использованием методов языка Python. Скрипт на Python, используемый для получения данных можно найти в разделе "Сопроводительные материалы" Скрипт 5.
6. Для анализа частот встречаемости старт-кодонов в геноме изучаемой бактерии были использованы методы программирования на языке Python. Для решения данной задачи требовались навыки работы с файлами, а также другие базовые понятия об основах программирования. В ходе выполнения программы был получен словарь со всеми значениями встречаемости различных старт-кодонов, в дальнейшем на его основе, с использованием библиотеки "matplotlib" была построена барограмма со всеми значениями старт-кодонов. Скрипт на Python, используемый для получения данных можно найти в разделе "Сопроводительные материалы" Скрипт S6.
7. Подсчет длин 5' и 3' - нетранслируемых областей белок кодирующих генов и сравнение этих значений с количеством последовательностей Шайна Дальгарно. Подсчет длин проводился с использованием метода электронных таблиц "COUNTIF". На основании полученных данных были построены гистограммы. А выявление количества SD последовательностей осуществлялось с помощью языка Python. Скрипт на Python, используемый для получения данных можно найти в разделе "Сопроводительные материалы" Скрипт 7.
Результаты и обсуждение
1. Длины белков, закодированных в геноме Salmonella enterica subsp. enterica serovar Typhimurium str. LT2
Гистограмма была построена с помощью некоторых методов электронных таблиц, описанных в разделе "Материалы и методы" (см. рис. 1). По оси абсцисс отложены диапазоны длин в аминокислотах, в которые могут попадать белки исследуемой бактерии; по оси ординат отложено количество значений длин белков, попадающих в определенные диапазоны.
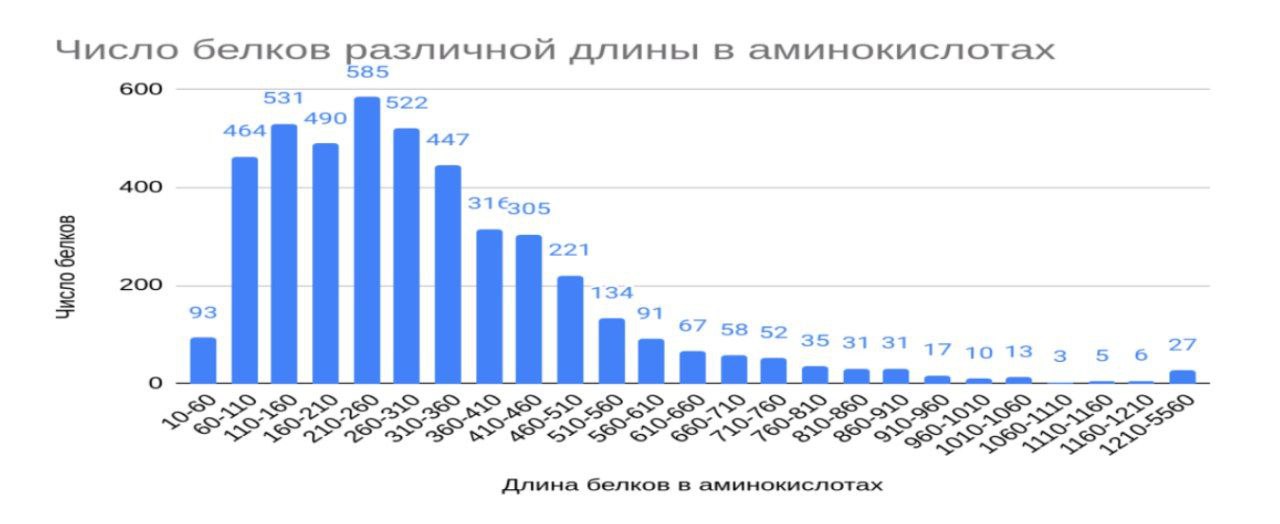
По гистограмме видно, что большая часть белков этой бактерии имеют размеры от 60 до 460 аминокислотных остатков.
2. Число генов белков и генов разных типов РНК в геноме
Таблица была построена с помощью описанных в разделе "Материалы и методы" методов электронных таблиц (см. таблицу 1). Всего у Salmonella enterica subsp. enterica serovar Typhimurium str. LT2 имеется два репликона: хромосома и одна плазмида под названием "PSLT".
| Тип гена | Хромосома | Плазмида | Всего |
|---|---|---|---|
| CDS кодирующие | 4452 | 408 | 4860 |
| псевдогены | 39 | 0 | 39 |
| tRNA | 85 | 0 | 85 |
| rRNA | 22 | 0 | 22 |
| ncRNA | 8 | 0 | 8 |
| SRP_RNA | 2 | 0 | 2 |
| misc_RNA | 0 | 4 | 4 |
| tm_RNA | 1 | 0 | 1 |
| Всего | 4609 | 412 | 5021 |
Из данных таблицы видно, что большая кольцевая хромосома содержит подавляющее большинство генов, кодирующих белки (4452, ~92% от общего числа генов), все псевдогены и гены всех типов РНК (кроме misc_RNA). Также нетрудно заметить, что плазмиды в основном содержат только белок-кодирующие гены, что логично, ибо плазмиды содержат, как правило, лишь небольшой набор генов, повышающих приспособленность организмов к условиям окружающей среды, в то время как основная генетическая информация, в частности, о различных видах РНК содержится в нуклеоиде (большой кольцевой хромосоме).
3. Распределение CDS по GC-составу
Была построена столбчатая диаграмма, отражающая распределение CDS бактерии Salmonella enterica subsp. enterica serovar Typhimurium str. LT2 по GC-составу.
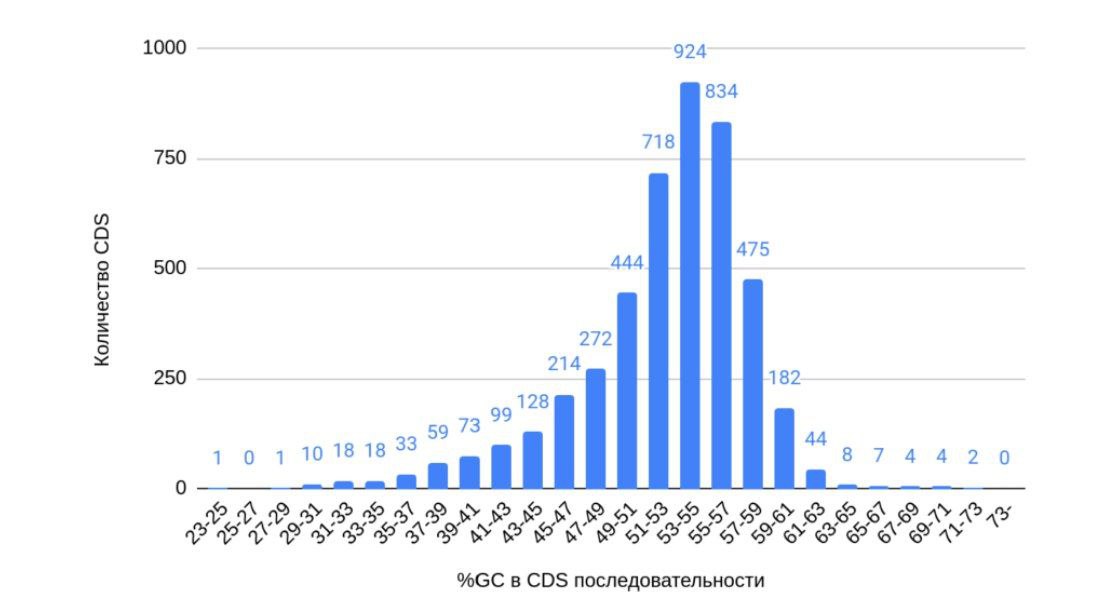
Полученное распределение имеет максимум в районе 53-55%. Также можно посчитать медианное значение, равное 53.5%, и среднее арифметическое значение, равное 52.4%. Полученные значения GC% состава генома позволяет предположить что бактерия обитает в условиях с умеренной температурой, такой вывод можно сделать исходя из того что у бактерии не наблюдается повышенного GC содержания нуклеотидных пар (повышенное содержание данных нуклеотидов увеличивает "прочность" и "устойчивость" генома за счёт образования между комплементарными основаниями тройной водородной связи).
4. Количественный подсчет нуклеотидов
С использованием ранее описанных методов была построена таблица количественного состава нуклеотидов.
| Нуклеотид | Количество |
|---|---|
| A | 1.183.215 |
| T | 1.181.621 |
| G | 1.294.057 |
| C | 1.292.490 |
По данным из этой таблицы можно определить встречаемость различных нуклеотидов в ДНК последовательности.
5. Анализ частот встречаемости старт-кодонов
Анализ проводился с использованием методов программирования на Python.
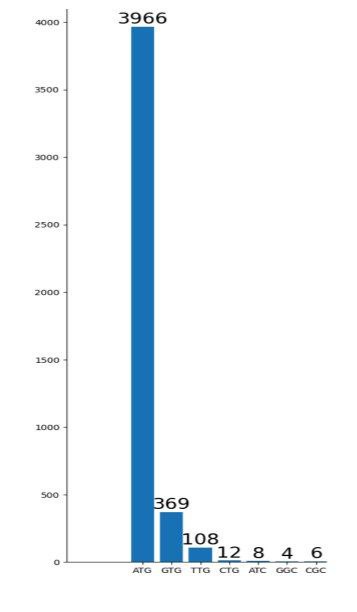
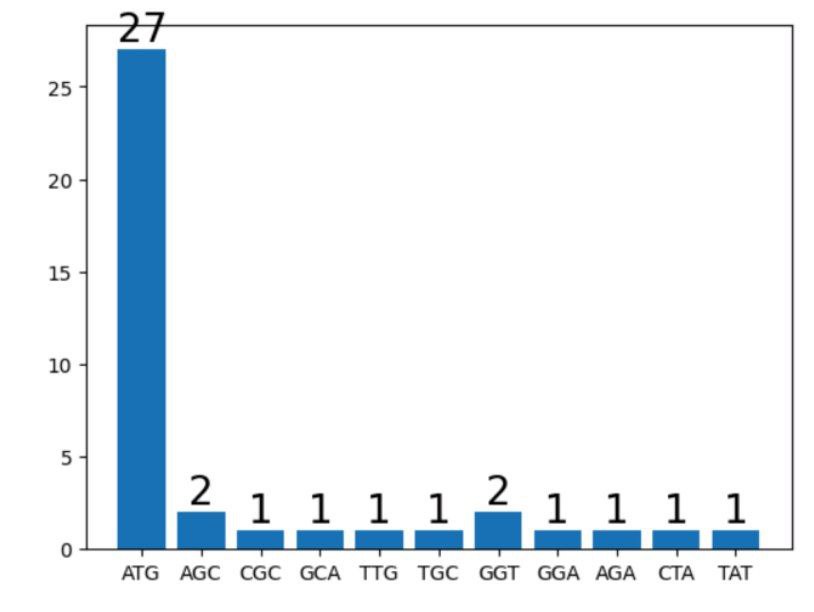
Как видно из барограмм наиболее распространенным триплетом старт кодона стал триплет ATG. Но при этом на схемах также заметен еще один столбец с высокими значениями — триплет ТТА. Мне не удалось найти достоверную информацию, объясняющую такое большое количество кодонов ТТА на позиции старт-кодона, поэтому я попробую предположить, что у данного вида бактерии функцию старт кодона выполняет не только типичный для большинства организмов кодон ATG, но и кодон ТТА.
6. Подсчет длин 5' и 3' нетранслируемых областей (НТО)
Описанным в разделе "Методы" способом были получены значения для длин различных 5' и 3' нетранслируемых областей всех белок кодирующих генов бактерии. Вывод о том что они являются нетранслируемыми можно сделать исходя из того что они входят в состав гена, но при этом не входят в белок кодирующую последовательность.
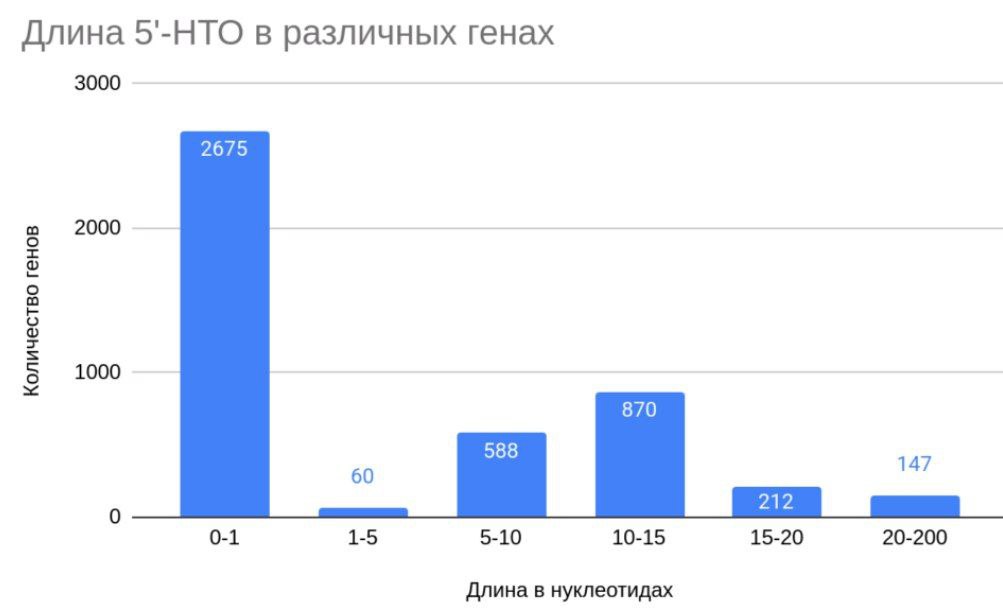
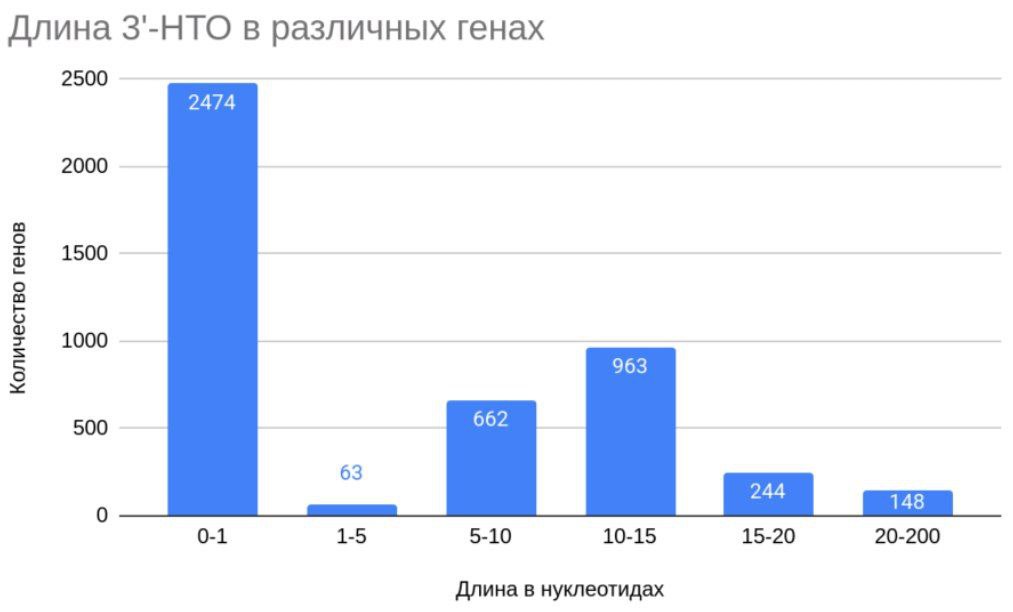
Исходя из полученных гистограмм можно сделать вывод о том что больше половины всех генов не содержат не транслируемых областей. Предположительно это связано с тем что геном бактерий представлен в основном оперонами, внутри которых мало некодирующих участков.
Далее были проанализированы SD последовательности с помощью методов Python. Из текста исследования "The distinct translational landscapes of gram-negative Salmonella and gram-positive Listeria", ясно что SD-последовательность сальмонелл имеет вид "AGGAGG". В результате с помощью программы было обнаружено что количество SD последовательностей равняется 512. Так как последовательности Шайна Дальгарно обычно находятся не вплотную к кодирующей области гена, а хотя бы за 10 нуклеотидов до нее, то из гистограммы мы будем учитывать только столбцы со значениями более 10 нуклеотидов. Методы подсчета получились довольно грубыми, но даже так явно заметно что количество SD-последовательностей коррелирует с количеством 5'-НТО определенных размеров.
Вывод
Полученные в работе данные позволяют получить общее представление об устройстве генома Salmonella enterica subsp. enterica serovar Typhimurium str. LT2. А именно можно получить сведения о длине белков, закодированных в геноме бактерии, о распределении генов ответственных за синтез различных РНК, о нуклеотидном составе генома и о его старт-кодонах в белок-кодирующих генах, а также о корреляции между количеством последовательностей Шайна Дальгарно и количеством 5'-НТО длиной более 10 нуклеотидов.
Благодарности
Автор выражает благодарность всему преподавательскому составу курса биоинформатики на ФББ МГУ за доступное изложение необходимого для написания данного мини-обзора материала, а также за обучение методам работы с реальными биоинформатическими данными.
Список литературы
- McClelland M. et al. Complete genome sequence of Salmonella enterica serovar Typhimurium LT2 // Nature. - 2001. Т. 413. - №. 6858. С. 852-856.
- Brenner, F. W.; Villar, R. G.; Angulo, F. J.; Tauxe, R.; Swaminathan, B. Salmonella Nomenclature. Journal of Clinical Microbiology.
- Геном бактерии из банка геномов на сайте NCBI: https://ftp.ncbi.nlm.nih.gov/genomes/all/GCF/000/006/945/GCF_000006945.2_ASM694v2.
- Hayes F. The function and organization of plasmids. // Methods In Molecular Biology (Clifton, N.J.). 2003. Vol. 235. - Р. 1-17.
- Silov S. et al. The use of the rare TTA codon in Streptomyces genes: significance of the codon context? // Indian Journal of Microbiology. 2021. Т. 61. №. 1. С. 24-30.
- The distinct translational landscapes of gram-negative Salmonella and gram-positive Listeria. https://www.nature.com/articles/s41467-023-43759-1.