Практикум 12
1. Написание Python скрипта
Для сравнения работы различных алгоритмов выравнивания я написал следующий код на Python:
#!/usr/bin/env python3
import argparse
import sys

def compare_alignments(file1, file2, output_file=None):
    with open(file1, "r") as f1:
        f1_dct = {}
        current_key = None
        for line in f1:
            line = line.strip()
            if line.startswith(">"):
                current_key = line
                f1_dct[current_key] = []
                counter = 1
            elif current_key:
                for c in line:
                    if c.isalpha():
                        f1_dct[current_key].append(counter)
                        counter += 1
                    else:
                        f1_dct[current_key].append("-")

    with open(file2, "r") as f2:
        f2_dct = {}
        current_key = None
        for line in f2:
            line = line.strip()
            if line.startswith(">"):
                current_key = line
                f2_dct[current_key] = []
                counter = 1
            elif current_key:
                for c in line:
                    if c.isalpha():
                        f2_dct[current_key].append(counter)
                        counter += 1
                    else:
                        f2_dct[current_key].append("-")

    answer = []
    f1_keys = set(f1_dct.keys())
    f2_keys = set(f2_dct.keys())
    if f1_keys != f2_keys:
        missing_in_f2 = f1_keys - f2_keys
        missing_in_f1 = f2_keys - f1_keys
        print(f"Ошибка: Наборы ID не совпадают!")
        if missing_in_f2: print(f"Нет во втором файле: {missing_in_f2}")
        if missing_in_f1: print(f"Нет в первом файле: {missing_in_f1}")
        sys.exit(1)

    key_list = sorted([key for key in f1_dct])
    f1_columns = []
    f1_len = len(list(f1_dct.values())[0])
    for ind in range(f1_len):
        f1_columns.append([f1_dct[key][ind] for key in key_list])
    f1_aln_len = len(f1_columns)

    f2_columns = []
    f2_len = len(list(f2_dct.values())[0])
    for ind in range(f2_len):
        f2_columns.append([f2_dct[key][ind] for key in key_list])
    f2_aln_len = len(f2_columns)

    for column in range(len(f1_columns)):
        if f1_columns[column] in f2_columns:
            answer.append(tuple((column + 1, f2_columns.index(f1_columns[column]) + 1)))

    blocks = []
    if answer:
        current_block = [answer[0]]
        for i in range(1, len(answer)):
            prev = answer[i - 1]
            curr = answer[i]
            if curr[0] == prev[0] + 1 and curr[1] == prev[1] + 1:
                current_block.append(curr)
            else:
                if len(current_block) > 1:
                    blocks.append(current_block)
                current_block = [curr]
        if len(current_block) > 1:
            blocks.append(current_block)

    formatted_blocks = []
    for b in blocks:
        formatted_blocks.append({
            "f1_range": (b[0][0], b[-1][0]),
            "f2_range": (b[0][1], b[-1][1]),
            "length": len(b)
        })

    elements_in_blocks = set()
    for b in blocks:
        for tuple_item in b:
            elements_in_blocks.add(tuple_item)
    answer_set = set(answer)
    no_blocks = sorted(list(answer_set - elements_in_blocks))

    if output_file:
        with open(output_file, "w") as f:
            f.
write("Список совпадающих колонок" + str(answer) + '\n' +
                    "Длина первого выравнивания: " + str(f1_aln_len) + '\n' +
                    "Длина второго выравнивания: " + str(f2_aln_len) + '\n' +
                    f"Процент одинаково выравненных колонок от длины первого: {round((len(answer)/f1_aln_len)*100, 2)}%" + '\n' +
                    f"Процент одинаково выравненных колонок от длины второго: {round((len(answer)/f2_aln_len)*100, 2)}%" + '\n' +
                    f'Список блоков одинаково выровненных колонок - {formatted_blocks}' + '\n' +
                    f'Список колонок, не входящих в блоки - {no_blocks}')
        print(f"Результат сохранен в {output_file}")
    else:
        print("Список совпадающих колонок:", answer)
        print("Длина первого выравнивания:", f1_aln_len)
        print("Длина второго выравнивания:", f2_aln_len)
        print(f"Процент от первого выравнивания: {round((len(answer)/f1_aln_len)*100, 2)}%")
        print(f"Процент от второго выравнивания: {round((len(answer)/f2_aln_len)*100, 2)}%")
        print(f'Блоки колонок - {formatted_blocks}')
        print(f'Колонки вне блоков - {no_blocks}')


parser = argparse.ArgumentParser(description="Скрипт для сравнения выравниваний.")
parser.add_argument("file1", help="Путь к первому файлу")
parser.add_argument("file2", help="Путь к второму файлу")
parser.add_argument("-o", "--output", help="Сохранить в файл")

if len(sys.argv) == 1:
    parser.print_help()
    sys.exit(1)

args = parser.parse_args()
compare_alignments(args.file1, args.file2, args.output)
На вход он получает два файла с выравниваниями по разным алгоритмам последовательности в формате Fasta и выдает:
Список кортежей, где (x, y): x — номер колонки в первом файле, y — номер соответствующей колонки во втором файле
Пример: [(1, 1), (2, 5), (3, 6)]
Длина первого выравнивания: число
Длина второго выравнивания: число
Процент одинаково выровненных колонок от длины первого выравнивания: число %
Процент одинаково выровненных колонок от длины второго выравнивания: число %
Список блоков одинаково выровненных колонок. В нем выдача имеет вид {‘f1_range’: (x1, y1), ‘f2_range’: (x2, y2)}, где f1_range - первый алгоритм выравнивания, f2_range - второй алгоритм выравнивания, x - номер столбца начала блока, y - номер столбца конца блока.
Список одинаково выровненных колонок, не входящих в блоки, он имеет вид - [(x, y)], где x - координата столбца первого алгоритма выравнивания, y - координата столбца второго алгоритма выравнивания
Код для сравниния выравниваний2. Сравнение выравниваний разных алгоритмов выравнивания
Для выравниваний использовались белковые последовательности Интерферонов первого типа (те же белки, что использовались для решения задач в Практикуме 11)
Сравнение выравниваний, полученных алгоритмами: Muscle и Clustal:
| Номер блока | Muscle (начало - конец) | Clustal (начало - конец) |
|---|---|---|
| 1 | 10 - 11 | 10 - 11 |
| 2 | 13 - 17 | 13 - 17 |
| 3 | 57 - 103 | 56 - 102 |
| 4 | 148 - 181 | 141 - 174 |
| 5 | 185 - 188 | 178 - 181 |
Сравнение выравниваний, полученных алгоритмами: Muscle и MAFFT:
| Номер блока | Muscle (начало - конец) | MAFFT (начало - конец) |
|---|---|---|
| 1 | 9 - 11 | 10 - 12 |
| 2 | 13 - 16 | 14 - 17 |
| 3 | 19 - 22 | 20 - 23 |
| 4 | 32 - 38 | 33 - 39 |
| 5 | 50 - 51 | 52 - 53 |
| 6 | 57 - 103 | 58 - 104 |
| 7 | 144 - 176 | 147 - 179 |
| 8 | 185 - 187 | 192 - 194 |
Исходя из выдачи программы, а именно из раздела “Процент одинаково выровненных колонок от длины первого выравнивания:”, можно сделать вывод о том что алгоритм Muscle имеет больше схожести с алгоритмом MAFFT. Такая рахница в выдаче объясняется разницей в рабооте алгоритмов. В основе MAFFT и Muscle лежит итеративное рафинирование, в то время как Clustal устроен другим образом (более подробно описан в Разделе 4)
3. Сравнение выравнивания по совмещению структур и выравнивания с помощью алгоритма Mafft
Было построено выравнивание по совмещению структур с помощью PDBeFold. В качестве последовательностей использовались следующие белки с общим доменом: Zebrafish interferon 2 (PDB ID: 3PIW), OVINE INTERFERON TAU (PDB ID: 1B5L), HUMAN INTERFERON-BETA CRYSTAL STRUCTURE (PDB ID:1AU1). Также в программе Jalview было построено выравнивание ранее перечисленных белков с использованием алгоритма Mafft. Построенные выравнивания были проанализированы с использованием программы, написанной в пункте 1.
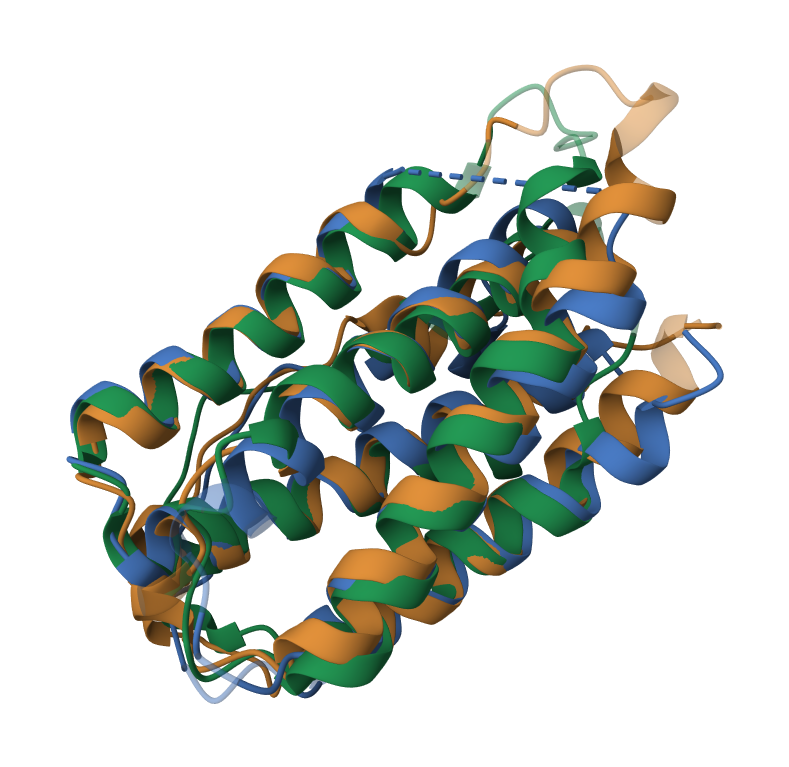
Исходя из выдачи программы можно сделать вывод о том что выравнивания построенные этими способами оказались схожи. Об этом можно сказать посмотрев на разделы: “Процент одинаково выровненных колонок от длины первого выравнивания: 51.69%” и “Процент одинаково выровненных колонок от длины второго выравнивания: 50.27%”. Так как процент одинаково выравненных колонок в структурном выравнивании оказался выше чем в выравнивании с использованием алгоритма MAFFT, можно сделать вывод о том, что сравнительно высокая степень пространственного сходства исследуемых белков при более низкой гомологии их последовательностей подтверждает консервативность третичной структуры в процессе эволюции, несмотря на их происхождение из разных организмов
4. Описание алгоритма множественного выравнивания Clustal
Программа создавалась в конце 1980-х годов как ответ на растущую потребность биологов сравнивать сразу несколько последовательностей. Первая версия появилась в 1988 году. Ключевой прорыв произошел в 1994 году с выходом ClustalW (где "W" означает weights — веса) и в 1997 году с графическим интерфейсом ClustalX.
ClustalW использует прогрессивный метод выравнивания, состоящий из этапов:
- Попарного выравнивания
- Построения направляющего дерева
- Прогрессивного выравнивания
Новая версия программы — Clustal Omega имеет другой принцип работы. Этапы алгоритма:
1. Построение направляющего дерева через mBed
В классических алгоритмах (как ClustalW) для построения дерева нужно сравнить каждую последовательность с каждой. Если у нас 100 000 последовательностей, это займет годы. Clustal Omega решает это с помощью алгоритма mBed:
- Выбор опорных точек (Seed sequences): Из всего набора выбирается небольшое количество последовательностей (корень квадратный из общего числа N).
- Векторное представление: Каждая последовательность из набора описывается вектором расстояний только до этих «опорных» точек, а не до всех остальных.
- Кластеризация: Последовательности со схожими векторами объединяются в группы. Это позволяет построить направляющее дерево за время O(N log N), что невероятно быстро по сравнению с классическим O(N²).
2. HMM-профили (Скрытые Марковские модели)
Это самое важное технологическое отличие. Вместо того чтобы просто сравнивать две последовательности по буквам, Clustal Omega превращает их в HMM-профили.
- Профиль — это статистическая модель, которая говорит не только о том, какая буква стоит в данной позиции, но и с какой вероятностью там может быть мутация, вставка или делеция.
- Алгоритм использует библиотеку HH-suite для выравнивания одного HMM-профиля относительно другого. Это позволяет улавливать «эволюционный сигнал» даже там, где прямое сходство букв почти исчезло.
3. Прогрессивное выравнивание (The Progress)
Имея направляющее дерево и HMM-модели, программа начинает сборку общего выравнивания:
- Движение от листьев к корню: Сначала выравниваются самые близкие пары последовательностей.
- Профиль-Профильное выравнивание: Когда две последовательности объединились, они образуют новый, более сложный профиль. Затем этот профиль выравнивается со следующим профилем (другой последовательностью или группой).
- Пересчет весов: На каждом шаге алгоритм динамически корректирует веса, чтобы избежать перекоса в сторону слишком похожих групп последовательностей.
Подробнее о работе алгоритма можно прочитать в статье — Fast, scalable generation of high-quality protein multiple sequence alignments using Clustal Omega [PMID: 21988835 PMCID: PMC3261699]