Сигналы и мотивы.
Поиск родственных белков при помощи паттерна.
Для анализа были взять последовательности белка Cas1 системы CRISPR Cas.
Данный белок в комплексе с Cas2 выполняет функцию вырезания последовательности
ДНК вируса и встраивания в собственный геном, для обеспечения адаптивного иммунитета.
При помощи следующих команд получим записи последовательностей с мнемоникой CAS1:
seqret 'fasta::/P/y24/term4/bacteria-sw.fasta:CAS1_*' CAS1.fasta


			grep '>' CAS1.fasta | wc -l

			15
Как показано выше, всего было получено 15 последовательностей Cas1.
Для построения мотива были взяты 10 последовательностей:
CAS1_PSEAB, CAS1_ECOLI, CAS1_MYCTU, CAS1_STRCL, CAS1_NEIM8, CAS1_CLOSS, CAS1_STRTR, CAS1_AQUAE, CAS1_CLOPS, CAS1_PECAS.
Для его построения
использовался консервативный участок, изображенный на рисунке 1. Выравнивание
последоватльеностей белков было получено при помощи программы mafft:
mafft 10_CAS1.fasta > 10_CAS1_align.fasta
Выравнивание 10 выбранных последовательностей.
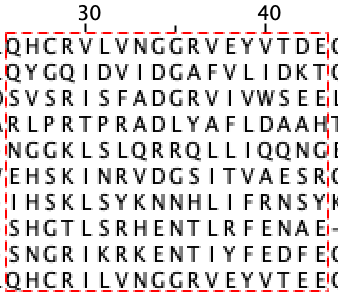
В итоге был получен следующий паттерн:
Паттерн консервативного участка Сas1.
[QSRNEI]-[HYVLGN]-[CGSP]-[RQKT]-[VITL]-[LDSPNK]-[VFRLY]-[NIAQVKH]-[GDRNE]-[GLRN]-[RAYQSHT]-[VFALI]-[EVIFLTRY]-[YLVIF]-[VIWDQARE]-[TDSAQEN]-[DKEANSF]
fuzzpro -sequence '/P/y24/term4/bacteria-sw.fasta' -pattern '[QSRNEI]-[HYVLGN]-[CGSP]-[RQKT]-[VITL]-[LDSPNK]-[VFRLY]-[NIAQVKH]-[GDRNE]-[GLRN]-[RAYQSHT]-[VFALI]-[EVIFLTRY]-[YLVIF]-[VIWDQARE]-[TDSAQEN]-[DKEANSF]' -outfile 'CAS1_fuzzpro.fasta'
Было получено 12 последовательностей, 12 из которых являются последовательностями
белка Cas1:
			cat CAS1_fuzzpro.fasta | grep '# Sequence: CAS1_' | wc -l

			12


			cat CAS1_fuzzpro.fasta | grep '# Sequence: ' | wc -l

			12
То есть:
TP - 12
FP - 0
FN - 3
Исходя из этих результатов, можно сказать, что паттерн оказался слишком строгим. При попытке его
'облегчить', заменяя позиции на X, начинает попадаться множество лишних последовательностей.
Это связано с тем, что несмотря на то, что выбирался участок консервативный относительно других
участков данной последовательности - он все еще сильно различается у разных организмов. Это неудивительо -
защитным системам бактерий не свойствена консервативность.
MEME
После этого, используя те же 10 последовательностей был построен профиль при помощи программы meme:
meme 10_CAS1.fasta -protein -mod oops -nmotifs 3 -minw 8 -maxw 15
Опции программы meme.
-mod oops - One Occurrence Per Sequence, ищет только один мотив в одной последовательности.

-minw 8 - минимальная длина мотива.

-maxw 15 - максимальная длина мотива.
Программа MEME обнаружила 3 мотива (зеленый, голубой и красный в выдаче), которые встретились во всех
10 последовательностях.
Затем, используя полученный профиль, при помощи программы mast, был произведен поиск по
последовательностям белков:
mast meme_out/meme.html /P/y24/term4/bacteria-sw.fasta
Выдача meme
Выдача mast
При помощи mast мы нашли 13 из 15 последовательностей с мнемоникой CAS1_*. Всего в выдаче
21 находка с E-value <= 0.05. Другие значимые находки представляют из себя другие типы CAS1 (например, CAS1A и CAS1B).
Шайн-Дальгарно
Последовательность Шайна-Дальгарно - участок мРНК, связывающий с рибосомой через рРНК и играющий
важную роль в инициации трансляции у многих прокариот.
При помощи программы fuzznuc был осуществлен поиск участков ДНК бактерии Paracidovorax citrulli
по паттерну AGGAGG:
fuzznuc -sequence '~/term1/genome/GCF_022493915.1_ASM2249391v1_genomic.fna' -complement -pattern 'A-G-G-A-G-G' -outfile SD.out
При помощи Python-скрипта были проанализированы находки программы fuzznuc - данный скрипт проверял
наличие последовательности Шайна-Дальгарно на расстоянии 8-12 нуклеотидов от первого нуклеотида
гена:
Python-скрипт.
#!/usr/bin/env python3
from collections import Counter
from Bio import SeqIO
import pandas as pd
import numpy as np
import argparse
import io

def init():
  parser = argparse.ArgumentParser()
  parser.add_argument("seq", help="Путь к нук. посл. генома")
  parser.add_argument("table", help="Путь к feature table")
  parser.add_argument("fuzz", help="Путь к находкам fuzznuc")
  args = parser.parse_args()

  genome =  open_genome(args.seq)
  get_ATGC(genome)
  fuzz_df = parse_fuzz(args.fuzz)
  feature_df = pd.read_csv(args.table ,sep='\t')

  count_right_SD(fuzz_df, feature_df)

def open_genome(path):
  records = SeqIO.parse(path, 'fasta')
  record = next(records)
  return  record.seq

def get_ATGC(genome):
  counter = Counter(genome)
  len_genome = len(genome)
  print(f'Genome length: {len_genome}')
  for N,percent in counter.items():
    percent = percent / len_genome * 100
    print(f'{N}\t{percent}')

def parse_fuzz(path):
  df_lines = []
  is_first_res = True
  with open(path, 'r') as f:
    for line in f.readlines():
      if line.startswith('#'):
        if not is_first_res:
          break
        continue
      else:
        if is_first_res and line.strip():
          is_first_res = False
        if line.strip():
          df_lines.append(line)
  return pd.read_csv(io.StringIO(''.join(df_lines)), sep='\s+')

def count_right_SD(fuzz_df, feature_df):
  feature_df = feature_df[feature_df['# feature']=='gene']

  plus_df = feature_df['start']
  minus_df = feature_df['end']
  plus_fuzz = fuzz_df[fuzz_df['Strand']=='+']['End']
  minus_fuzz = fuzz_df[fuzz_df['Strand']=='-']['Start']

  spacers_plus = plus_df.values[:, np.newaxis] - plus_fuzz.values - 1
  mask = ((spacers_plus >= 5) & (spacers_plus <= 12)).any(axis=0)
  fuzz_df.loc[plus_fuzz.index, 'is_real_SD'] = mask.astype(int)

  spacers_minus = minus_fuzz.values - minus_df.values[:, np.newaxis] - 1
  mask = ((spacers_minus >= 5) & (spacers_minus <= 12)).any(axis=0)
  fuzz_df.loc[minus_fuzz.index, 'is_real_SD'] = mask.astype(int)

  print(f'Всего найдено посл. AGGAGG: {len(fuzz_df)}')
  print(f'Верные - посл. Шайн-Дальгарно: {fuzz_df["is_real_SD"].sum()}, {fuzz_df["is_real_SD"].sum()/len(fuzz_df)*100}%')
  print(f'Неверные посл.: {len(fuzz_df)-fuzz_df["is_real_SD"].sum()}, {(len(fuzz_df)-fuzz_df["is_real_SD"].sum())/len(fuzz_df)*100}%')


if __name__ == '__main__':
  init()
Результаты работы Python-скрипта.
Genome length: 4902232
T       15.639488298391427
C       34.36267398197393
A       15.502734264718601
G       34.49510345491605
Всего найдено посл. AGGAGG: 2220
Верные - посл. Шайн-Дальгарно: 84.0, 3.783783783783784%
Неверные посл.: 2136.0, 96.21621621621622%
У нас получилось, что мы нашли всего O=2220 последовательностей AGGAGG на обеих цепях.
Зная частоты встречаемости нуклеотидов, посчитаем z-статистику:
p=p(A)^2*p(G)^4+p(T)^2*p(C)^4=0.00068
E=p*N= 3333.52 - ожидаемое число последовательностей Шайн-Дальгарно на двух цепях.
z = (O-E)/sqrt(E) = (2220 - 3333.52) / sqrt(3333.52) = -19.29
То есть последовательность AGGAGG встречается реже, чем мы могли бы ожидать.
Редкую встречаемость самой последовательности можно объяснить функциональной ролью -
если бы она встречалась повсеместно и часто, то она могла бы мешать процессу инициации
трансляции.
Также из результатов работы скрипта видно, что из 2220 найденных,
находятся на расстоянии 8-12 нуклеотидов от начала открытой рамки считывания
генов лишь 84 (3.78%).
Полученные результаты можно объяснить слишком строгим паттерном: последовательность
Шайна-Далагрно не является строго-консервативной, а наш поиск не будет учитывать
их даже при единичной (и более) замене нуклеотида (при этом функциональность данной последовтаельности
сохраняется в полной мере).