
Сравнение трёх программ MSA
Использованы 33 последовательности семейства PF00261 — Tropomyosin, выбранного в практикуме 11. Выравнивание A получено Clustal Omega, B — MAFFT, C — MUSCLE. Во всех трёх файлах подтверждено совпадение исходных последовательностей после удаления гэпов.
Колонки сравнивались программно по номерам исходных аминокислотных остатков во всех последовательностях, с учётом расположения гэпов. Колонка считалась совпадающей, если она содержала тот же набор остатков и гэпов в другом MSA. Нумерация колонок начинается с 1. Длины выравниваний A, B и C составляют 289, 290 и 287 колонок соответственно.
| Пара | Длины MSA | Совпавшие колонки | Доля в первом MSA | Доля во втором MSA |
|---|---|---|---|---|
| A–B | 289 / 290 | 64 | 22,15% | 22,07% |
| A–C | 289 / 287 | 65 | 22,49% | 22,65% |
| B–C, дополнительно | 290 / 287 | 215 | 74,14% | 74,91% |
Совпадающие блоки и одиночные колонки
Запись (s1:f1)=(s2:f2) задаёт координаты одного и того же блока в
первом и втором выравниваниях; границы включены. Для этих файлов совпадающие
блоки имеют одинаковые номера в обоих MSA, но в общем случае это не
обязательно.
| Сравнение | Координаты в первом и втором MSA | Длина |
|---|---|---|
| A–B | (136:156)=(136:156) |
21 |
| A–B | (185:226)=(185:226) |
42 |
| A–C | (136:156)=(136:156) |
21 |
| A–C | (186:227)=(186:227) |
42 |
| A–C | (279:280)=(279:280) |
2 |
| Сравнение | Колонка первого MSA | Колонка второго MSA |
|---|---|---|
| A–B | 279 | 279 |
| A–C | Нет | Нет |
| Сравнение | Участок первого MSA | Участок второго MSA |
|---|---|---|
| A–B | 157–184 | 157–184 |
| A–B | 227–278 | 227–278 |
| A–C | 157–185 | 157–185 |
| A–C | 228–278 | 228–278 |
Обсуждение
Для A–B найдено 64 совпадения: два блока длиной 21 и 42 колонки и одиночная колонка 279. Для A–C найдено 65 совпадений: три блока длиной 21, 42 и 2 колонки. По числу одинаково выровненных колонок MUSCLE немного ближе к Clustal Omega, чем MAFFT; разница составляет всего одну колонку.
MAFFT и MUSCLE значительно более сходны между собой: 215 совпадающих колонок, или 74,14% длины B и 74,91% длины C. Эти проценты характеризуют согласованность результатов, а не их биологическую правильность: выравнивание A используется как база сравнения и не является заведомо верным эталоном.
Структурное выравнивание и MAFFT
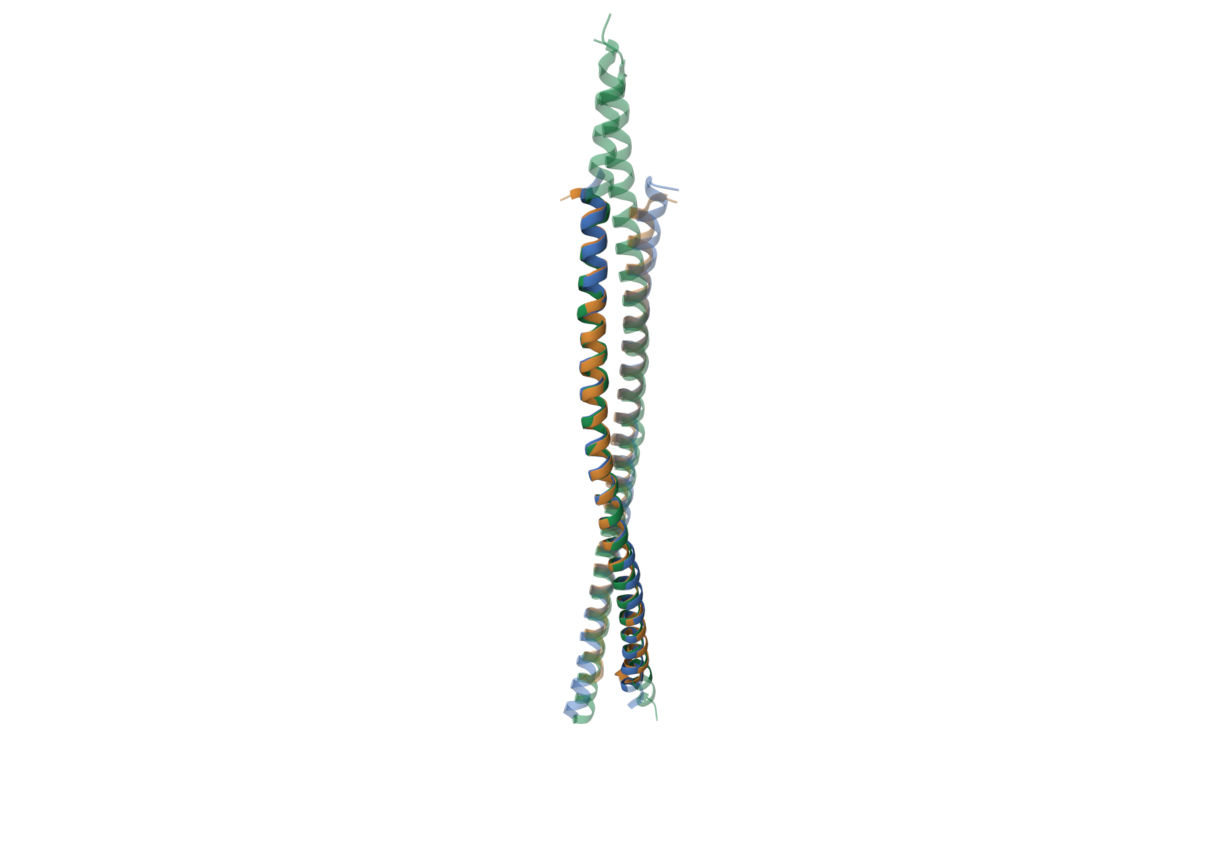
Для анализа использованы последовательности цепей A из трёх структур тропомиозина: 1IC2, 3U1A и 3U59. Каждая цепь представлена одной записью, без дубликатов. Указанные длины относятся к используемым фрагментам.
| PDB и цепь | Аминокислот в используемой последовательности |
|---|---|
| 1IC2.A | 79 |
| 3U1A.A | 82 |
| 3U59.A | 100 |
Получение сравниваемых выравниваний
Структурное MSA (S) восстановлено из двух сохранённых парных структурных выравниваний: 1IC2.A–3U1A.A и 1IC2.A–3U59.A. Общим референсом служит последовательность 1IC2.A. Перед объединением из исходного текстового файла удалены номера пар, не являющиеся аминокислотами.
Парные выравнивания объединены по номерам остатков референса 1IC2.A. Вставки разных цепей, не имеющие остатка-партнёра в референсе, размещены раздельно. Обратная проекция общего MSA на каждую исходную пару точно восстанавливает её после удаления колонок из двух гэпов. Длина общего структурного MSA — 103 колонки.
Последовательностное MSA (M) заново построено для трёх уникальных последовательностей программой MAFFT 7.525 в режиме L-INS-i. Длина результата — 100 колонок.
Результаты программного сравнения
| Показатель | Результат |
|---|---|
| Длина структурного MSA (S) | 103 колонки |
| Длина MAFFT (M) | 100 колонок |
| Совпадающие колонки | 6 |
| Доля совпадений в S / M | 5,83% / 6,00% |
| Сравнение | Координаты в S и M | Длина |
|---|---|---|
| S–M | (98:99)=(96:97) |
2 |
| S–M | (102:103)=(99:100) |
2 |
| Колонка S | Колонка M |
|---|---|
| 2 | 1 |
| 95 | 93 |
Полные интервалы без совпадающих колонок: в S — 1,
3–94, 96–97, 100–101; в M —
2–92, 94–95, 98. Интервалы перечислены
отдельно для каждого MSA и не означают попарного соответствия участков.
Обсуждение
Совпали только 6 колонок: два блока длиной 2 и две одиночные колонки. Во всех шести совпадениях присутствует остаток 3U59.A и гэпы в двух остальных строках. Следовательно, они не подтверждают совпадение выравнивания общих участков трёх цепей.
Основное расхождение связано с положением 3U59.A относительно референса. Например, остаток 1 цепи 1IC2.A в исходном структурном выравнивании сопоставлен с остатком 15 цепи 3U59.A, а в MAFFT — с остатком 3 этой цепи. Такой сдвиг изменяет состав колонок на большей части выравнивания.
Низкое совпадение двух MSA само по себе не доказывает ошибочность MAFFT. Результат зависит от исходных структурных соответствий и способа объединения вставок.
Исходные парные выравнивания
Краткое описание MAFFT
MAFFT — программа множественного выравнивания белковых и нуклеотидных последовательностей. Название расшифровывается как Multiple Alignment using Fast Fourier Transform. Первую версию описали Kazutaka Katoh и соавторы в 2002 году.
В ряде стратегий быстрое преобразование Фурье помогает обнаруживать сходные участки последовательностей. Пакет объединяет прогрессивное выравнивание и методы итеративного улучшения. MAFFT предлагает несколько стратегий с разным соотношением скорости и точности.
| Стратегия | Принцип и применение |
|---|---|
| FFT-NS-1 | Быстрое прогрессивное выравнивание по приближённому направляющему дереву. |
| FFT-NS-2 | Повторное построение дерева и второй проход прогрессивного выравнивания. |
| FFT-NS-i | Итеративное улучшение начального выравнивания. |
| L-INS-i | Использует локальные парные выравнивания; подходит для последовательностей с одним общим выравниваемым доменом и фланкирующими участками. |
| G-INS-i | Использует глобальные парные выравнивания; подходит, когда последовательности выравниваются по всей длине. |
| E-INS-i | Предназначен для нескольких консервативных участков, разделённых длинными вставками. |
FFT-NS-i не является универсально самым точным режимом MAFFT. Выбор стратегии зависит от размера набора, числа общих доменов и характера вставок. Для небольшого набора из трёх цепей в задании 3 использован L-INS-i.
Преимущества и ограничения
MAFFT работает с белковыми и нуклеотидными последовательностями, поддерживает командную строку и позволяет выбирать между быстрыми и более требовательными к ресурсам методами. Выигрыш во времени и качество зависят от данных; увеличение длины последовательностей само по себе не гарантирует преимущество перед любой другой программой.