Для сравнения выравниваний я использовала код Елены Гончаровой
(compare_aln.py).
Я сравнивала MSA одних и тех же семи последовательностей ACNA (из практикума 9), построенные программами MUSCLE, MAFFT и Clustal Omega (в отчёте — Clustal). За референс A приняла MUSCLE; пары сравнения: A с B (MUSCLE–MAFFT) и A с C (MUSCLE–Clustal).
Файлы выравниваний: pr12_muscle.fa, pr12_mafft.fa, pr12_clustal.fa.
Проект Jalview со сравниваемыми выравниваниями: pr12.jvp.
Таблица 1. Сводка сравнения MUSCLE и MAFFT
| Параметр | MUSCLE | MAFFT |
|---|---|---|
| Длина выравнивания | 963 | 962 |
| Совпадающих колонок | 862 | |
| % от длины | 89.5% | 89.6% |
| Число блоков (длина ≥ 2) | 10 | |
| Одиночных совпадений вне блоков | 1 — (807,806) | |
Таблица 2. Блоки одинаково выровненных колонок (MUSCLE = MAFFT)
| (s1,f1) MUSCLE | (s2,f2) MAFFT | Длина |
|---|---|---|
| (469,661) | (468,660) | 193 |
| (212,359) | (214,361) | 148 |
| (809,925) | (808,924) | 117 |
| (86,200) | (88,202) | 115 |
| (723,805) | (722,804) | 83 |
| (18,81) | (20,83) | 64 |
| (665,720) | (664,719) | 56 |
| (366,404) | (369,407) | 39 |
| (930,963) | (929,962) | 34 |
| (423,434) | (422,433) | 12 |
Крупные несовпадающие участки в MUSCLE (между блоками): 1–17, 201–211, 405–422, 435–468 и др. — в основном около N-конца и в середине, где у ACNA_MYCTU протяжённая вставка.
Таблица 3. Сводка сравнения MUSCLE и Clustal
| Параметр | MUSCLE | Clustal |
|---|---|---|
| Длина выравнивания | 963 | 958 |
| Совпадающих колонок | 859 | |
| % от длины | 89.2% | 89.7% |
| Число блоков (длина ≥ 2) | 11 | |
| Одиночных совпадений вне блоков | 0 | |
Таблица 4. Блоки одинаково выровненных колонок (MUSCLE = Clustal)
| (s1,f1) MUSCLE | (s2,f2) Clustal | Длина |
|---|---|---|
| (465,663) | (460,658) | 199 |
| (208,363) | (207,362) | 156 |
| (86,200) | (85,199) | 115 |
| (809,901) | (804,896) | 93 |
| (723,804) | (718,799) | 82 |
| (667,720) | (662,715) | 54 |
| (43,81) | (42,80) | 39 |
| (366,404) | (365,403) | 39 |
| (930,963) | (925,958) | 34 |
| (1,31) | (1,31) | 31 |
| (909,925) | (904,920) | 17 |
Самый длинный разрыв совпадений в MUSCLE — участок 405–464 (длина 60), снова в зоне вариабельной середины.
Оба сравнения дают высокую долю одинаково выровненных колонок (~89%). По проценту совпадений от длины MUSCLE ближе к MAFFT (89.5%), чем к Clustal (89.2%). У MUSCLE–MAFFT блоки крупные и идут почти непрерывно по длине белка; у MUSCLE–Clustal блоков чуть больше (11), но суммарная длина совпадающих колонок чуть меньше, а разрыв в середине длиннее. Дополнительно MAFFT vs Clustal даёт уже 87.9% совпадений — то есть MAFFT и Clustal расходятся между собой сильнее, чем каждый из них с MUSCLE.
Вывод: на этом наборе последовательностей B (MAFFT) больше похоже на A (MUSCLE), чем C (Clustal). Различия сосредоточены у концов и в «дыре» ~колонки 400–470 (вставка у ACNA_MYCTU), где программы по-разному размещают гэпы.
Для пункта 3 я взяла три структуры WW-доменов (семейство PF00397) из разных белков человека: 1I6C (PIN1), 1K9Q (YAP1) и 2KPZ (NEDD4), цепь A. PDB-файлы: 1I6C.pdb, 1K9Q.pdb, 2KPZ.pdb; последовательности цепей — в pr12_proteins.fasta.
Последовательностное MSA — MUSCLE (pr12_proteins_muscle.fa). Структурное совмещение и выравнивание я сделала в RCSB PDB Pairwise Structure Alignment методом TM-align, референс — 1I6C:A (открыть сессию с результатами). Инструмент даёт попарные структурные выравнивания к референсу; FASTA пар: pr12_rcsb_1I6C_1K9Q.fa, pr12_rcsb_1I6C_2KPZ.fa.
Таблица 5. Оценки TM-align на RCSB (референс 1I6C:A)
| Структура | RMSD, Å | TM-score | Identity | Выровнено остатков |
|---|---|---|---|---|
| 1K9Q:A | 2.15 | 0.44 | 35% | 29 |
| 2KPZ:A | 2.10 | 0.51 | 38% | 30 |
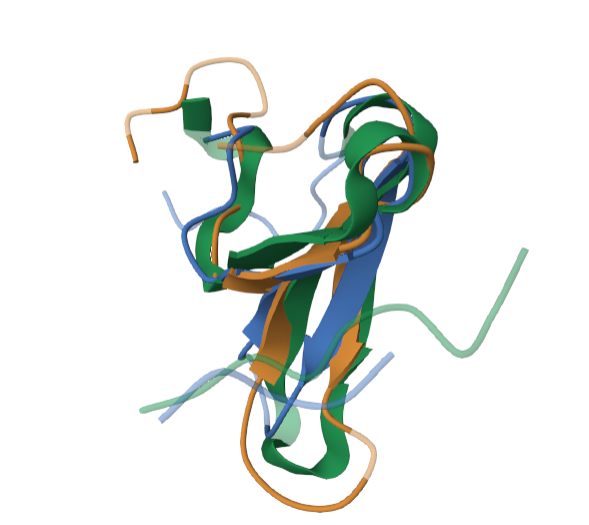
TM-score ~0.4–0.5 при identity ~35–38%: ядро складки общее (три антипараллельных β-тяжа WW), но последовательности заметно разошлись. У 2KPZ моделируется 34 из 49 остатков цепи (гибкие концы), поэтому покрытие по моделированным остаткам выше (88%), чем у 1K9Q (73%).
Рисунок. Совмещение WW-доменов 1I6C, 1K9Q и 2KPZ (зелёный / оранжевый / синий). Ядро складки совпадает; расхождения в основном в петлях и на концах.
Из MSA MUSCLE я извлекла те же пары, что даёт RCSB (для 2KPZ — только
упорядоченное ядро из 34 аа), и сравнила через
compare_aln.py:
pr12_muscle_1I6C_1K9Q.fa /
pr12_rcsb_1I6C_1K9Q.fa,
pr12_muscle_1I6C_2KPZ.fa /
pr12_rcsb_1I6C_2KPZ.fa.
Списки пар колонок:
compare_muscle_rcsb_1I6C_1K9Q.tsv,
compare_muscle_rcsb_1I6C_2KPZ.tsv.
Таблица 6. Сводка: MUSCLE vs RCSB
| Пара | Длина MUSCLE | Длина RCSB | Совп. колонок | % от MUSCLE | Блоков ≥ 2 |
|---|---|---|---|---|---|
| 1I6C–1K9Q | 46 | 50 | 39 | 84.8% | 4 |
| 1I6C–2KPZ | 39 | 41 | 35 | 89.7% | 2 |
Таблица 7. Блоки одинаково выровненных колонок
| Пара | (s1,f1) MUSCLE | (s2,f2) RCSB | Длина |
|---|---|---|---|
| 1I6C–1K9Q | (23,40) | (27,44) | 18 |
| 1I6C–1K9Q | (10,19) | (12,21) | 10 |
| 1I6C–1K9Q | (1,7) | (1,7) | 7 |
| 1I6C–1K9Q | (42,45) | (46,49) | 4 |
| 1I6C–2KPZ | (3,34) | (5,36) | 32 |
| 1I6C–2KPZ | (38,39) | (40,41) | 2 |
Наложение на RCSB показывает, что три WW-домена действительно делят одну складку (низкий RMSD ~2.1 Å при умеренном TM-score). По колонкам MUSCLE совпадает со структурным выравниванием на ~85–90%: лучше для пары PIN1–NEDD4 (один крупный блок из 32 колонок), чуть слабее для PIN1–YAP (разрывы у N-конца YAP и в петле). Расхождения — в основном гэпы на концах и в коротких петлях, где последовательность «угадывает» иначе, чем Cα-суперпозиция.
Вывод: для этих WW-структур последовательностное и структурное выравнивания в ядре домена согласованы, но не тождественны; картинка совмещения это подтверждает визуально.
MAFFT является, пожалуй, самым интересным с точки зрения решения задачи MSA среди всех программ, т.к. подходит к решению со стороны физико-химических свойств и мат. анализа, а не исключительно дискретной математики и теории алгоритмов. Концептуально алгоритм превращает последовательность в сигнал, путём сопоставления каждой аминокислоте её характеристики (размер боковой цепи + полярность). С сигналом уже можно работать, как с волной, применяя к нему мат. аналитический аппарат, в том числе быстрые преобразования Фурье (FFT) — это первый этап. Собственно алгоритм:
Говоря «применяется FFT», я подразумеваю: перекодировав аминокислоты, мы получаем по 2 числовых ряда (для объёма и полярности) на последовательность. Теперь нас интересует, а насколько будут похожи последовательности, если мы будем сдвигать одну относительно другой — для этого мы считаем сумму произведения членов рядов со сдвигом — кросс-корреляция. Это сложно вычислительно, так что применяем FFT и вычисляем спектры обоих сигналов, и уже перемножаем их, проводим обратное FFT и имеем кросс-корреляцию, для значений которой мы ищем пики — якоря, а Н.–В. используем для пробелов.
Источники: A Modified Multiple Alignment Fast Fourier Transform with Higher Efficiency (https://pubmed.ncbi.nlm.nih.gov/26890922/), полный текст был изучен на Sci-hub.