Практикум 12. Сравнение выравниваний
2. Сравнение выравниваний, построенных тремя разными программами
Для сравнения использовались семь последовательностей семейства 6PGD. Выравнивания построены программами MUSCLE, MAFFT и ClustalW.
Гиперссылки на сравниваемые выравнивания (FASTA):
Проект Jalview с тремя выравниваниями: 6PGD_three.jvp
Для того, чтобы сравнить выравнивания, я использовала код, написанный моими однокурсниками.
MUSCLE и MAFFT
| MUSCLE | MAFFT | Длина блока |
|---|---|---|
| (6,7) | (5,6) | 2 |
| (9,249) | (8,248) | 241 |
| (252,307) | (251,306) | 56 |
| (322,469) | (321,468) | 148 |
| (472,476) | (471,475) | 5 |
| (480,484) | (479,483) | 5 |
| (487,495) | (486,494) | 9 |
Одиночные совпадающие колонки: (316, 315).
Всего совпадающих колонок: 467. Длина MUSCLE 497, MAFFT 496. Процент совпадения: 93.96% и 94.15%.
MUSCLE и ClustalW
| MUSCLE | ClustalW | Длина блока |
|---|---|---|
| (6,7) | (5,6) | 2 |
| (9,168) | (8,167) | 160 |
| (171,249) | (170,248) | 79 |
| (252,306) | (251,305) | 55 |
| (321,467) | (319,465) | 147 |
| (472,476) | (469,473) | 5 |
| (479,484) | (476,481) | 6 |
| (487,495) | (484,492) | 9 |
Одиночных совпадающих колонок нет.
Всего совпадающих колонок: 463. Длина MUSCLE 497, ClustalW 494. Процент совпадения: 93.16% и 93.72%.
Обсуждение
При сравнении выравниваний MUSCLE и MAFFT обнаружено 7 блоков одинаково выровненных колонок (467 колонок, ~94%). Между MUSCLE и ClustalW — 8 блоков (463 колонки, ~93%). Оба сравнения дают высокий процент совпадений, что говорит о высокой консервативности семейства 6PGD: все три программы выравнивают эти последовательности почти одинаково.
Тем не менее, MAFFT ближе к MUSCLE, чем ClustalW: у пары MUSCLE–MAFFT больше совпадающих колонок и есть самый длинный блок (241 колонка), тогда как у MUSCLE–ClustalW самый длинный блок — 160 колонок. ClustalW чаще сдвигает гэпы, что и даёт меньшее совпадение.
3. Сравнение выравнивания по совмещению структур с выравниванием MSA
Для этого задания выбраны три структуры белка Ras (PF00071) из PDB: 5P21 (H-Ras), 1CTQ (H-Ras в комплексе с GAP) и 2RGA (H-Ras Q61I). Совмещение выполнено в PDBeFold (множественное выравнивание).
Ссылки на выравнивания в формате FASTA:
Проект Jalview: pdbefold_vs_muscle.jvp
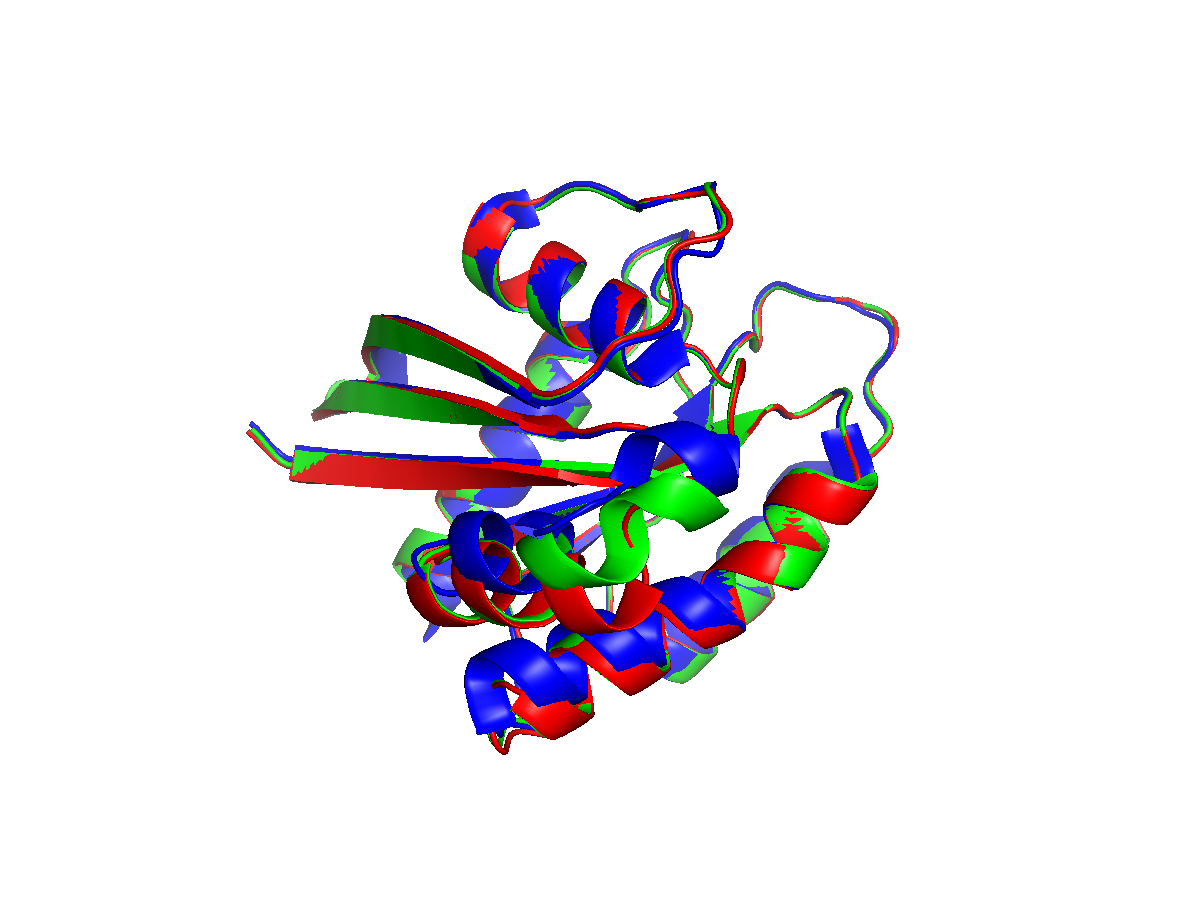
Результат сравнения (PDBeFold и MUSCLE):
| PDBeFold | MUSCLE | Длина блока |
|---|---|---|
| (1, 63) | (1, 63) | 63 |
| (67, 167) | (66, 166) | 101 |
Одиночных совпадающих колонок нет.
Статистика: длина PDBeFold — 167, длина MUSCLE — 166. Совпадающих колонок — 164 (98.20% от PDBeFold и 98.80% от MUSCLE).
Обсуждение
Выравнивание MUSCLE практически полностью воспроизводит структурное выравнивание PDBeFold: 164 из 166 колонок совпадают. Различие только в одной колонке — PDBeFold вставил дополнительный гэп на участке 64–66, а MUSCLE обошёлся без него. Это значит, что для консервативного участка белка Ras MSA-выравнивание MUSCLE согласуется с истинным эволюционным (структурным) выравниванием, а расхождения возникают только в отдельных участках.
4. Краткое описание программы MUSCLE
MUSCLE (MUltiple Sequence Comparison by Log-Expectation) — программа для множественного выравнивания белковых и нуклеотидных последовательностей, разработанная Робертом Эдгаром и опубликованная в 2004 году в журнале Nucleic Acids Research [1].
Как работает. Алгоритм MUSCLE включает три стадии:
- Быстрая оценка попарных расстояний (по k-мерам) и построение чернового дерева, по которому выполняется первое прогрессивное выравнивание.
- Пересчёт расстояний по уже выровненным последовательностям, построение уточнённого дерева и второе прогрессивное выравнивание.
- Итеративное уточнение (refinement): дерево разрезается, две группы перевыравниваются, и новый вариант принимается, если улучшает целевую функцию.
Преимущества:
- Высокая точность на стандартных тестовых наборах (BAliBASE, SABmark, SMART, PREFAB) — сопоставима или выше, чем у ClustalW и T-Coffee.
- Высокая скорость: в режиме fast в 10–100 раз быстрее ClustalW при близкой точности.
Недостатки:
- Снижение точности при идентичности последовательностей ниже 15–20%.
- Не использует 3D-структуры (в отличие от 3D-Coffee), только последовательности и статистические оценки профилей.
- При большом числе последовательностей точность заметно падает.
Источники:
- Edgar R. C. MUSCLE: multiple sequence alignment with high accuracy and high throughput // Nucleic Acids Research. — 2004. — Т. 32, № 5. — С. 1792–1797. DOI: 10.1093/nar/gkh340
- Thompson J. D. et al. A comprehensive benchmark study of multiple sequence alignment methods: current challenges and future perspectives // PLoS ONE. — 2011. — Т. 6, № 3. — e18093.