Практикум 10. HMM-профили и эволюционные доменыT
Выбор семейства и подсемейства
Выбранное семейство: PF01584 (CheW-like domain). Белки CheW являются частью сигнального механизма хемотаксиса у бактерий. Взаимодействуют с метилакцепторными хемотаксисными белками (MCP) и передают сигналы на CheY.
- Идентификатор: PF01584
- Мнемоника: CheW
- Название: CheW-like domain
CheW-подобные домены взаимодействуют с метилакцепторными хемотаксическими белками и передают сигнал белку CheY, регулирующему направление вращения жгутиков. Белки рассматриваемого семейства играют ключевую роль в контроле направления перемещения бактерий: к источникам питательных веществ или от токсичных компонентов среды.
- Количество последовательностей в выравнивании seed: 194
- Количество последовательностей в выравнивании full: 26,369
- Количество доменных структур: 194
Выбранное подсемейство: CheW-CZB. Оно представляет собой специализированную группу регуляторных белков, характерных для некоторых патогенных бактерий, которые совмещают в себе функции структурного адаптера хемотаксиса (домен CheW) и сенсора воспаления/цинка (домен CZB). Регулирует хемотаксис, позволяя патогенным бактериям хемотаксически реагировать на внутренний окислительный стресс или уходить от очагов воспаления и атак иммунной системы хозяина.
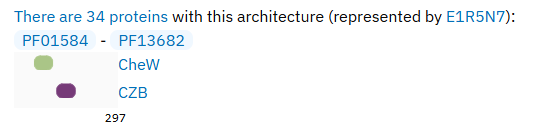
Рис. 1. Выбранное подсемейств CheW-CZB.
Белки подсемейства были скачаны в файл protein_sequences.fasta
Получение выравнивания доменов CheW
Для выделения границ домена CheW был написан скрипт domain_extractor.py, который парсит скачанные последовательности, выделяет AC, отправляет запрос на UniProt API и получает ответ в виде файла JSON. Затем программа проверяет наличие обоих доменов (CheW и CZB) – это необходимо, так как не на всех записях UniProt домен CZB аннотирован и в таких записях длина домена CheW отличается в 2 раза от других записей, что не соответствует реальности. К тому же, такие белки нельзя однозначно отнести к рассматриваемому подсемейству из-за того, что наличие CZB-домена не подтверждено.
После фильтрации скрипт парсит границы домена CheW и вырезанные домены
CheW записывает в файл CheW.fasta,
а необрезанные отфильтрованные последовательности – в файл
CheW_unextracted.fasta
(этот файл понадобится в будущем).
Команда для запуска и лог выполнения:
> python .\domain_extractor.py -inp protein-sequences.fasta -domain "CheW-like" -include_domains "Chemoreceptor zinc-binding" -out CheW.fasta -unextracted CheW_unextracted.fasta
A0A0M3DK50: missing required domains: Chemoreceptor zinc-binding
A0A0X1U780: missing required domains: Chemoreceptor zinc-binding
A0A1H8DNA9: missing required domains: Chemoreceptor zinc-binding
A0A518EMB4: missing required domains: Chemoreceptor zinc-binding
A0A5P3XI88: missing required domains: Chemoreceptor zinc-binding
A0ABR6YUJ1: missing required domains: Chemoreceptor zinc-binding
A0ABY5XYY0: missing required domains: Chemoreceptor zinc-binding
A0ABY6HG79: missing required domains: Chemoreceptor zinc-binding
A0ACH3DN57: missing required domains: Chemoreceptor zinc-binding
A0ACH4B8A6: missing required domains: Chemoreceptor zinc-binding
E1R5N7: missing required domains: Chemoreceptor zinc-binding
H6LHP5: missing required domains: Chemoreceptor zinc-binding
Done. Output written to CheW.fasta
Unextracted sequences written to CheW_unextracted.fasta
Из исходных 34 белков программа отсеяла 12 белков из-за отсутствия в JSON-описании UniProt домена CZB.
С помощью Jalview выполнено выравнивание доменов CheW алгоритмом Muscle. Получен файл CheW_muscle.fasta
Построение профиля HMM
На основе выравнивания был построен HMM-профиль подсемейства:
hmmbuild CheW.hmm CheW_muscle.fasta
Полученный файл CheW.hmm содержит описание HMM-профиля: позиционные веса для каждой аминокислоты и вероятности переходов между состояниями Match, Insert и Delete.
Поиск HMM-профилем
Семейство PF01584 содержит 51 тысячу белков, из которых 34 аннотированны на UniProt. Последовательности аннотированных белков были скачаны в файл CheW_reviewed.fasta. Этот файл был объединен с файлом CheW_unextracted.fasta в итоговый файл CheW_ur.fasta, и с ним велась дальнейшая работа.
По полученной базе с использованием построенного ранее hmm-профиля был выполен поиск с помощью программы hmmsearch:
hmmsearch --tblout results_ur.tbl -o results_ur.txt CheW.hmm CheW_ur.fasta
Мне удобнее работать с файлом в формате tbl, поэтому я запустил программу с двумя форматами выдачи сразу. Получены файлы results_ur.txt и results_ur.tbl.
Определение оптимального порога находки
Минимальный вес среди 22 белков подсемейства составил 58.1, максимальный среди 34 reviewed-белков (не относящихся к подсемейству) – 63.4. При упорядочивании всех найденных белков по убыванию веса наблюдается разрыв: после самого высокого reviewed (63.4) следующим идёт белок подсемейства с весом 70.8. Однако два белка подсемейства имеют вес меньше, чем 63.4 (62.4 и 58.1).
На основании этого я выбрал порог на вес находки 70. Распределение следующий вид:
Таблица 1. Распределение полученных результатов
| True | False | |
|---|---|---|
| Positive | 20 | 0 |
| Negative | 34 | 2 |
Расположение отсчётных файлов
Все отсчётные файлы расположены в директории ~/term4/pr10
- Выравнивание последовательностей доменов подсемейства: CheW_muscle.fasta
- Профиль HMM: CheW.hmm
- Последовательности белков семейства: CheW_ur.fasta
- Результат поиска: results_ur.txt